
Бишкек, 14.07.26. /Кабар/. Инженер по машинному обучению лаборатории AIRUN Intelligence Lab Зарина Увалиева опубликовала научную работу, посвященную развитию технологий искусственного интеллекта для кыргызского языка. Исследование было представлено в рамках воркшопа MeLLM международной конференции ACL 2026 (Association for Computational Linguistics), которая считается одной из самых авторитетных мировых площадок в области обработки естественного языка и искусственного интеллекта.
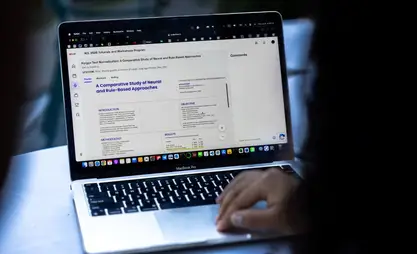
Как рассказала Зарина Увалиева агентству «Кабар», исследование под названием Kyrgyz Text Normalization: A Comparative Study of Neural and Rule-Based Approaches посвящено нормализации кыргызского текста — одной из базовых задач современных языковых технологий. Разработанная технология позволяет искусственному интеллекту корректно понимать кыргызский язык в том виде, в котором пользователи пишут его в интернете: с опечатками, разговорной лексикой, без знаков препинания и заглавных букв.
«Когда мы получаем текст вроде "салам кандайсын кайдасын", система должна преобразовать его в "Салам! Кандайсың? Кайдасың?" прежде чем выполнять дальнейшую обработку. Для английского, русского или китайского языков такие решения уже существуют, а для кыргызского языка их практически не было», — пояснила исследователь.
По ее словам, публикация исследования имеет значение не только для самой работы, но и для развития всей сферы компьютерной лингвистики в Центральной Азии.
«До настоящего времени в материалах конференции ACL было крайне мало исследований из Центральной Азии и практически не было работ из Кыргызстана. Это означает, что регион становится заметным на карте мировой компьютерной лингвистики и получает новые возможности для международного сотрудничества, участия в грантах и подготовки будущих исследователей», — отметила Увалиева.
В рамках исследования команда создала крупнейший на сегодняшний день открытый датасет для кыргызского языка, содержащий 1,67 млн пар «исходный текст — нормализованный текст». Исследователи также сравнили несколько современных методов нормализации текста. По результатам оценки носителями языка разработанная модель продемонстрировала точность 99,8% и показала меньшее количество ошибок по сравнению с моделью Gemma 4 компании Google DeepMind, несмотря на значительно меньший размер.
По словам Зарины Увалиевой, открытый доступ к датасету и модели позволит разработчикам значительно быстрее создавать цифровые продукты на кыргызском языке без необходимости тратить месяцы на сбор собственных данных.
Исследование выполнено командой, в которую вошли Зарина Увалиева, Бектемир Кумарбай уулу, Адилет Метинов, Тынчтыкбек Ташбалтаев и Нуртилек Алибеков.
По словам исследовательницы, публикация работы на площадке конференции подтверждает, что разработки, созданные в Кыргызстане, способны не только решать прикладные задачи внутри страны, но и вносить вклад в развитие мировой науки в области искусственного интеллекта.